 Pulse
Инспекторы качества
Сверено с выпуском 0.36.0, 14.11.2026.
Слабые и дешёвые агенты пишут быстро, но по-разному. Инспектор — сильная модель, которая читает Diff чужой работы, ставит оценку и объясняет, что не так. Оценки копятся в разрезе «агент и модель»: видно, кому что доверять и какие корректировки давать в инструкциях.
Инспектор ничего не правит: его роль — review, и политика запрещает ей запись файлов и
команды независимо от режима (см. Контроль).
Как запустить
Кнопкой. В шапке задачи — «Качество». Pulse берёт последнюю работу агента в этой задаче, поднимает сессию-инспектора на сильнейшей доступной модели и отдаёт ей Diff. Рядом с кнопкой появляется чип с оценкой; клик открывает отчёт с находками.
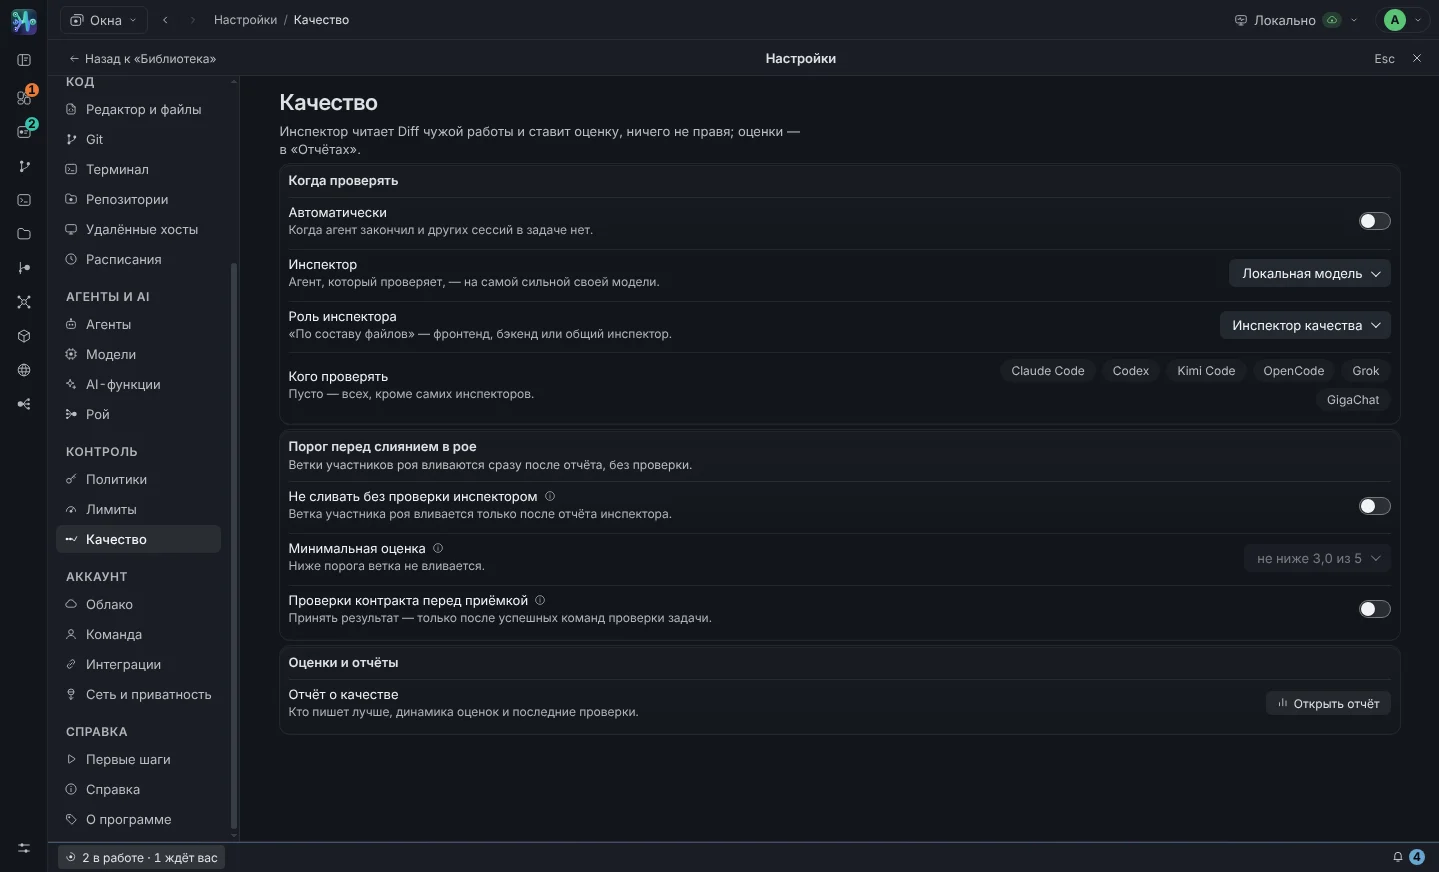
Автоматически. Настройки → Качество → «Автоматически». Проверка стартует, когда агент отработал всю очередь ходов и в задаче нет других идущих сессий. Одна и та же работа дважды не проверяется, сессии самих инспекторов не проверяются, бюджет задачи учитывается.
В рое. Добавьте в состав роли «Инспектор фронтенда» и «Инспектор бэкенда» (готовый состав — «С инспекцией»). Тогда архитектор может давать им задания наравне с остальными, а их отчёты возвращаются ему и влияют на следующую волну правок.
Что оценивает
Шесть осей, каждая от 0 до 5:
| Ось | Что смотрит |
|---|---|
| Корректность | делает ли код то, что просили, без багов и краевых дыр |
| Читаемость | имена, структура, соответствие стилю проекта |
| Тесты | покрыты ли изменения проверками, прогонялись ли они |
| Безопасность | секреты, валидация ввода, опасные вызовы |
| В рамках задачи | нет ли лишних правок и самодеятельности |
| Комментарии | объяснено ли неочевидное, обновлены ли документы |
Кроме оценок инспектор возвращает:
- вердикт — можно принимать / нужны правки / переделать;
- находки — «файл:строка — проблема — как исправить» с критичностью (критично, важно, мелочь);
- корректировку — одну фразу, что требовать от этого агента в следующий раз.
Кто проверяет
По умолчанию инспектор — Claude Code на самой сильной доступной модели (Opus или Fable). Агента можно сменить в настройках; модель Pulse выбирает сам из кэша вариантов агента.
Роль инспектора выбирается по составу изменённых файлов: перевес клиентских файлов — «Инспектор фронтенда», серверных — «Инспектор бэкенда», смешанные — «Инспектор качества». Можно закрепить роль вручную. «Кого проверять» — каких агентов; пусто — всех, кроме самих инспекторов.
Порог перед слиянием
Настройки → Качество, раздел «Порог перед слиянием в рое»:
- «Не сливать без проверки инспектором» — ветка участника роя вливается в ветку задачи только после отчёта инспектора и при оценке не ниже «Минимальной оценки». Ниже порога работа остаётся у участника, а архитектор получает отказ, где инспектор называет обе цифры и свой вердикт.
- «Проверки контракта перед приёмкой» — если у задачи заданы команды проверки, принять результат можно только после их успешного запуска для той же версии результата. Это отдельное правило выпуска, не оценка инспектора.
Сравнение агентов
Дашборд → Аналитика → Качество (из Настройки → Качество — кнопка «Открыть отчёт»): «кто пишет лучше» — таблица по ключу «агент + модель» — средний балл, число проверок, средние по каждой оси, критичные находки и последняя корректировка. Лидер подсвечен. Там же динамика оценок и последние отчёты целиком, с раскрытием находок.
Так выглядит реальная проверка: Claude Opus 5 в роли инспектора фронтенда посмотрел работу
GigaChat-2-Max и поставил 0,5 из 5 с вердиктом «переделать» — несобирающийся модуль
токенов, несуществующие пропсы у общих компонентов, 543 файла node_modules в коммите.
Корректировка агенту: «требуй доказательство сборки — вывод tsc и тестов в отчёте».
Что учесть
- Проверка стоит денег. Инспектор — сильная модель, и каждая проверка это отдельная сессия. Автопроверку включайте осознанно; бюджет задачи её останавливает так же, как обычную работу (см. Контроль).
- Материал инспектора — Diff с содержимым новых файлов, список файлов, текст задачи, что агент сам сказал о работе, заметки задачи и память репозитория. Большой Diff обрезается, инспектор дочитывает файлы сам.
- Оценка субъективна. Она полезна для сравнения агентов между собой на ваших задачах, а не как абсолютная метрика. Чем больше проверок, тем осмысленнее таблица.
- Инспектор может ошибиться. Его находки — повод посмотреть код, а не приговор. Читайте отчёт, а не только балл.
Рецензент в проверках (агент над Pulse)
Тот же инспектор, но не в окне, а в проверках репозитория самого Pulse: на каждый запрос слияния — прогон модели с профилем ревьюера, замечания комментарием. Оси, вердикт и формат ответа — ровно те же, что описаны выше, поэтому оценка из проверок и оценка из окна сравнимы между собой.
Отличие одно, и оно определяет всё остальное: в окне инспектор смотрит работу своего агента, а в проверках — чужой код, который может быть враждебным. Diff пишет тот, чью работу проверяют, и в нём может лежать текст, обращённый к модели: в комментарии, в README, в тесте, в описании запроса слияния. Модель прочитает его наравне с кодом.
Что с этим сделано
| Риск | Что сделано | Что осталось |
|---|---|---|
| Проверяемый текст командует рецензентом | У рецензента нет инструментов: один запрос, Diff внутри него как данные, обратно — JSON. Недоверенная часть отгорожена меткой со случайной солью, которую Diff не знает и потому не может закрыть | Испорченное замечание. Закрыть нельзя: это свойство модели, а не настройки |
| Указание подсунуто именем файла | Имя файла целиком выбирает автор ветки, поэтому имена лежат ВНУТРИ меток наравне с Diff: снаружи, где системный промпт обещает модели «это указания от проекта», остаются только числа, которые считает сам рецензент. Само имя при этом сверяется с теми же оборотами, что и строки Diff (разделители читаются как пробелы), и попытка называется человеку | Имя, написанное слитно, список оборотов не поймает — как и новую формулировку в тексте |
| Задание из форка добирается до ключа | Пайплайн запроса из форка идёт в самом форке, где переменных проекта нет; сверх этого задание само отказывается работать, когда проект ветки не равен проекту прогона | — |
| Рецензент что-то меняет в репозитории | Токен комментария — с ролью Reporter: он физически не может пушить. Наружу уходят только разобранные поля ответа, сырой текст модели — никогда | — |
| Ответ модели становится командой GitLab | Строка комментария, начинающаяся со слэша, — это быстрая команда (/merge, /approve). Слэш в начале строки экранируется, упоминания @имя заворачиваются в код |
— |
| Рецензент дёргает людей именем файла | @ — обычный символ имени файла, а список «не поместилось в бюджет» печатается в комментарии. Пути проходят ту же чистку, что и текст модели: упоминание заворачивается в код, обратные кавычки заменяются (иначе имя вышло бы из кода), перевод строки в имени не рвёт строку |
— |
Последние строки — не мелочь: без них «рецензент без права писать в репозиторий» получал бы это право через собственный комментарий, а «недоверенные данные отгорожены» переставало бы быть правдой ровно для того куска запроса, который автор ветки выбирает свободнее всего.
Чего закрыть нельзя, и это выбор владельца
.gitlab-ci.yml берётся из проверяемой ветки. Кто может запушить ветку в проект, тот может
переписать задание рецензента и забрать ключ модели. Никакой код в репозитории этому не
помешает — вопрос решается одной настройкой в GitLab, и у неё два исхода:
Переменная PULSE_REVIEW_KEY |
Рецензент на запросах слияния | Ключ доступен |
|---|---|---|
| защищённая (по умолчанию) | не работает, говорит «ключа модели нет» | только защищённым веткам и тегам — то есть ночному прогону на main |
| незащищённая | работает на каждом запросе | любому, кто может писать в ветку этого проекта |
Третьего не дано: «рецензент на каждый запрос слияния» и «ключ недоступен ветке запроса слияния» на GitLab несовместимы. Пока выбор не сделан, действует первый вариант — рецензент молчит и говорит, почему, а не притворяется работающим.
Что смягчено независимо от выбора: код самого рецензента задание достаёт из целевой
ветки, поэтому проверяемая ветка не исполняет свой вариант скрипта рядом с ключом. И в
задании нет npm ci: установка исполнила бы postinstall из проверяемой ветки, то есть
чужой код рядом с ключом. Рецензенту хватает стандартной библиотеки Node.
Что рецензент говорит о себе
Каждый комментарий заканчивается разделом «Чего рецензент не видел»: файлы, не поместившиеся в бюджет, пропущенное как сгенерированное и — всегда — остальной код репозитория, история, результаты сборки и тестов. Без этого раздела отсутствие замечаний по файлу читалось бы как «файл в порядке», хотя файла могло не быть в запросе вовсе.
Diff режется под бюджет только целыми файлами: обрезанный посередине Hunk выглядит как
законченный кусок кода, и модель делает по нему уверенные выводы о том, чего не видела.
Цена решения: файл больше бюджета не попадает в проверку вовсе — и об этом сказано вслух.
Код идёт вперёд документации: на живом изменении весь бюджет иначе выедали CHANGELOG.md,
README.md и снимок кода, а полсотни файлов исходников не смотрелись.
Найденные замечания не красят прогон ни в какой цвет: рецензент не ворота, решает
человек. Цветом выражается другое — посмотрели код или нет. У GitLab нет нейтрального
исхода, поэтому он собран из кода выхода: 0 — посмотрели, 78 — не посмотрели
(предупреждение на прогоне), остальное — сломался сам рецензент. Зелёное «не проверяли»
читалось бы как «проверено, всё хорошо» про непроверенный код.
Что нужно завести владельцу
В Settings → CI/CD → Variables проекта:
| Переменная | Что это |
|---|---|
PULSE_REVIEW_API |
адрес OpenAI-совместимого эндпоинта, https:// (по http ключ не отправляется) |
PULSE_REVIEW_MODEL |
имя модели |
PULSE_REVIEW_KEY |
ключ; masked, и решение про protected — по таблице выше |
PULSE_REVIEW_TOKEN |
токен проекта с ролью Reporter — только чтобы оставить комментарий |
PULSE_REVIEW_ENABLED=0 |
выключатель, если рецензент надоел |
GigaChat этим скриптом не поддержан: ему нужны OAuth и корень НУЦ Минцифры (см. docs/gigachat.md) — это отдельный транспорт, и живого прогона по той дороге не было.
Чем это проверено
Про рецензента легко написать больше, чем проверено, — поэтому здесь сказано, что именно доказано файлами.
- Чистая часть (
src/shared/ciReview.test.ts): решение о запуске, бюджет Diff, поиск обращений к модели, сборка промпта и обеззараживание ответа — проверки над функциями. - Сквозная проверка (
src/shared/ciReviewScript.test.ts): настоящийscripts/ci/review.mjsзапускается дочерним процессом над временным git-репозиторием, а вместо модели и GitLab на петле стоят поддельные серверы, записывающие каждый запрос. Отсюда берётся утверждение, которого не даёт ни одна проверка над функциями: при пяти разных отказах (форк, выключено владельцем, неподходящий источник, нет ключа, некуда писать) сервер модели не получает ни одного запроса, а задание выходит с кодом 78. Там же проверено, что в запросе нет поляtools, что имя файла с «указанием» остаётся внутри меток и при этом названо человеку находкой, что имя с@не превращается в упоминание, и что ответ не по формату даёт «не проверяли», а не зелёнку с комментарием. - Чего проверками не доказать: что настоящая модель послушается рамки промпта. Это свойство модели, и оно названо в таблице рисков выше как незакрытое.
Файл со сквозной проверкой лежит в src/shared/, а не рядом со скриптом, по прозаической
причине: vitest настроен на src/**/*.test.ts, и проверка рядом со скриптом не запускалась
бы никогда — то есть выглядела бы написанной, ничего не проверяя.
Где код
| Слой | Файл |
|---|---|
| Решение о запуске, бюджет Diff, промпт, обеззараживание ответа | src/shared/ciReview.ts (+ ciReview.test.ts) |
| Ввод-вывод: git, один запрос к модели, комментарий | scripts/ci/review.mjs (+ сквозная src/shared/ciReviewScript.test.ts) |
Задания рецензент и ночной рецензент |
.gitlab-ci.yml |
| То же для GitHub — не исполнялось ни разу | .github/workflows/review.yml |
Посмотреть, что уйдёт в модель, ничего не отправляя:
node --experimental-transform-types --import ./scripts/ts-loader.mjs \
  scripts/ci/review.mjs --base=main --head=HEAD --dry-run
Рецензент намеренно не входит в список обязательных проверок
(src/shared/contributorCommits.ts): обязательная проверка — это ворота, а мнение модели
воротами быть не может.
Куда это ведёт
Накопленные оценки и корректировки — материал для следующего шага: подправить инструкцию агента (она версионируется, см. Память и контекст), поменять модель у роли в рое или перестать давать этому агенту задачи, которые он стабильно проваливает.